
鹈鹕骑自行车基准:提示词、示例与局限
试试让语言模型写出鹈鹕骑自行车的 SVG,比较绘图结果,并记录让比较有意义的模型设置和运行条件。
最近更新: 2026-10-29
作者 Stometa · 核验依据与日期见正文中的来源和运行记录。
鹈鹕基准要求语言模型编写一张「鹈鹕骑自行车」的 SVG。它是一项直观的小实验:模型能否把一句描述变成可辨认的形状,以及关系合理的画面?
原始提示词
Generate an SVG of a pelican riding a bicycle
这是历史静态 SVG 提示词(pelican-v1)。与历史画作比较时,请使用上面的原文、新建对话,并保留未经修改的回复。让图像生成器输出位图是另一项任务,应与语言模型编写 SVG 的结果分开比较。
Simon Willison 在 2024 年 10 月记录了这项实验,并维护着公开结果仓库。本站历史示例均链接到来源。这些示例来自不同时间,不能视为对今天各家服务的受控测试。
现在的 HTML 动画测试
首页参与流程
使用 Pelican Test 的 pelican-bicycle-cli-v1 提示词:生成自包含的 HTML/SVG
动画,不调用工具或子 agent。它与上面的历史静态 SVG
题目不同,请只比较提示词、模型设置和评分器版本一致的结果。
可以把提示词发给任意 Agent。终端连接器目前专门调用本机 Codex CLI,并不自动支持所有 Agent。完成后,网站会将 HTML、静态评分、effort 和 SVG 缩略图带入草稿;登录、检查内容并提交审核即可。只有 Canvas、没有 SVG 的作品需要补一张截图。复测 Skill 也可以分析其他 Agent 已生成的文件,此时不需要 Codex。
评分检查静态结构、SVG 丰富度、动画标记与工程细节,不验证画面是否正确、后端模型身份或模型是否降智。投稿评分始终标注为用户提交。
先看哪些细节
先记录能明确讨论的画面特征:
- 鹈鹕: 能否认出鸟、长喙和喉囊。
- 自行车: 两个轮子是否由合理的车架连接,是否有车座和车把。
- 骑行关系: 鸟是否坐在车上,身体和肢体的位置是否合理。
- SVG: 文件能否渲染,内容是否超出画布,形状与图层关系是否连贯。
画风偏好因人而异。画得好看不能直接证明代码能力更强。先描述「前轮与车架脱离」这样的具体问题,再写整体感受。
从这些示例开始
打开GPT-4o 的历史示例查看来源,再浏览其他模型的画作。每个结果页提供多种尺寸的分享图。比较前先核对模型标签与来源日期,不要默认它们来自同一时期。
社区投稿和它们的标签
另有九份社区投稿使用动画 prompt,而不是上面的静态 SVG prompt:八份要求画鹈鹕,一份要求画海鸥。它们发布于 2026 年 9 月 23 日至 10 月 9 日,下面按日期排列。标签按投稿者原样抄录,拼写也不改,本站没有验证模型身份。自报分数来自 html-svg-heuristic-v2,它描述静态 HTML/SVG 结构,不涉及画面好坏。比较任何两份之前,先看各自的 prompt 与产物。有两份投稿的标签相同,都是 gpt-6-astra (ultra),在同一评分器名下自报 93 分和 98 分,同一个标签内部就差了 5 分。
- 9 月 23 日:标注为「GPT6-Luna medium」;画面文字为简体中文的鹈鹕 prompt;未显示分数。
- 9 月 23 日:标注为「gpt-6-sol (medium)」,自报 76 分;英文鹈鹕 prompt;自报分数 76/100。
- 9 月 24 日:标注为「GPT-6-Sol Xhigh」;英文鹈鹕 prompt;未显示分数。
- 9 月 24 日:标注为「GPT-6-Astral Xhigh」;英文鹈鹕 prompt;未显示分数。
- 9 月 26 日:标注为「gpt-6-astra (ultra)」,自报 93 分;英文鹈鹕 prompt;自报分数 93/100。
- 9 月 30 日:标注为「SOL6.1 (xhigh)」;要求画一只穿着服装的海鸥而非鹈鹕,与其余八份不同口径;未显示分数。
- 10 月 1 日:标注为「gpt-6.1-sol-max」;英文鹈鹕 prompt;未显示分数。
- 10 月 7 日:标注为「gpt-6-astra (ultra)」,自报 98 分;英文鹈鹕 prompt;自报分数 98/100。
- 10 月 9 日:标注为「GPT-6.1 Sol (low)」;画面文字为简体中文的鹈鹕 prompt;未显示分数。
2026 年 9 月 15 日:新一轮 CLI 实测
我们用同一句提示词运行了 12 次:GPT-5.6 Sol 和 GPT-6 Astra,分别选择 low 与 high 推理强度,每组运行三次。这些来自新的独立 CLI 会话,与历史图库示例分开记录。下方按运行编号保留了全部尝试,没有重画 SVG。
模型和推理强度记录来自 CLI 请求参数,不能独立验证后端快照。使用 Codex CLI 0.154.0,在只读临时目录中运行,关闭用户配置与项目文档加载。运行时指令、skills 和工具仍然可用,部分尝试调用了工具;每次运行都提示 skill 描述因上下文预算而缩短;同时最多有两个运行。这是一组 CLI 行为观察,不是无工具的模型对照实验,也不能证明质量回退。
我们从最终回复提取 SVG;其中一次回复使用 data URL,经百分号解码得到 SVG。PNG 预览只为统一画布添加了白色留边。运行记录与原始 SVG包含时间、请求设置、哈希、提取方式和工具调用次数。没有为了得到更好的画作而重试。
先用保留的 9 月 15 日运行清单核对方法,再评价画作:
| 请求设置 | 尝试次数 | 提取到 SVG | 调用过工具的尝试 |
|---|---|---|---|
| GPT-5.6 Sol · low | 3 | 3 | 1 |
| GPT-5.6 Sol · high | 3 | 3 | 3 |
| GPT-6 Astra · low | 3 | 3 | 0 |
| GPT-6 Astra · high | 3 | 3 | 0 |
12 次尝试使用相同提示词,但当时允许调用工具,其中 4 次实际调用了工具。提取到 SVG 只说明回复包含 SVG,不能给鹈鹕、自行车或编程质量打分。复现这组观察时,应保留每档全部 3 次结果,并单独记录工具使用情况;不能凭这些计数排列模型名次。
查看全部 12 次尝试及原始 SVG
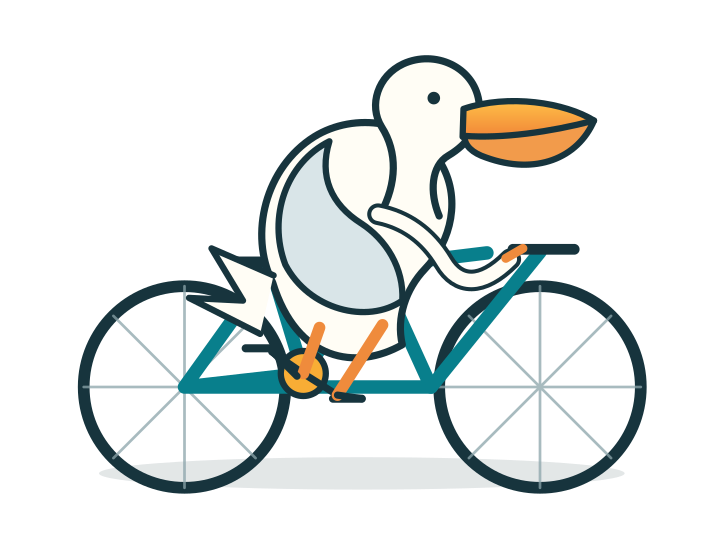
gpt-5.6-sol
low · 运行 1
原始 SVG
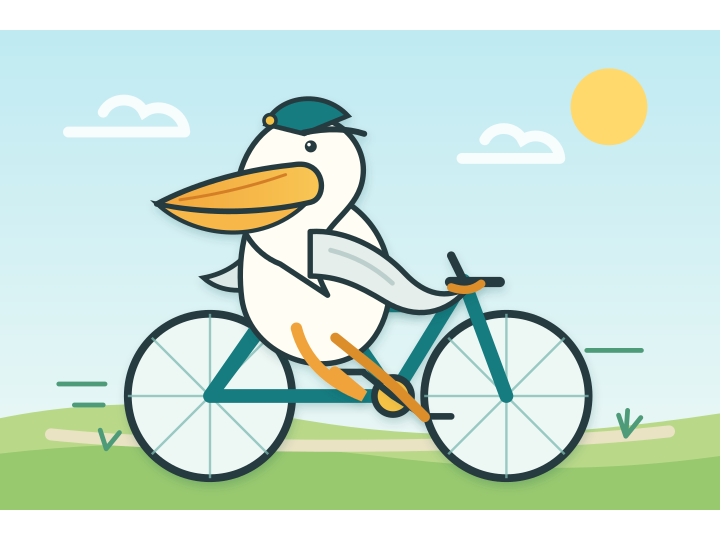
gpt-5.6-sol
high · 运行 1
原始 SVG
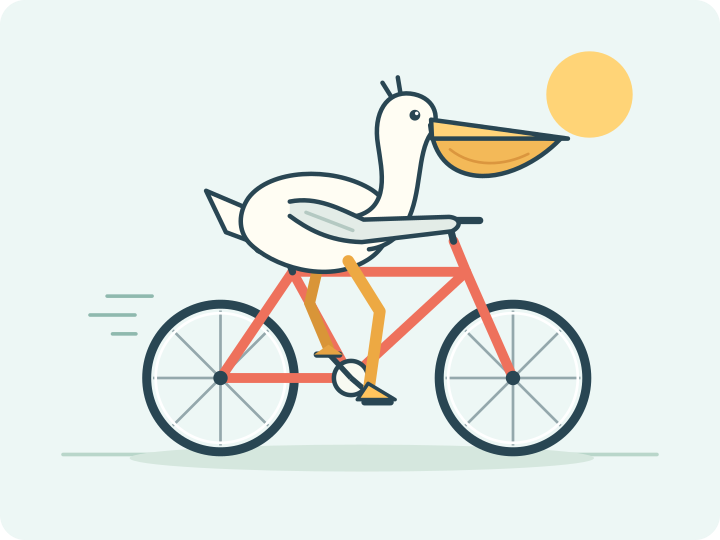
gpt-6-astra
low · 运行 1
原始 SVG
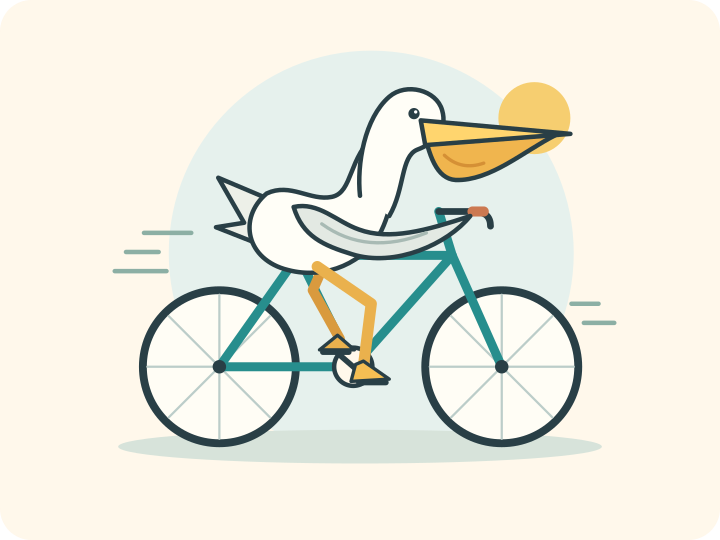
gpt-6-astra
high · 运行 1
原始 SVG
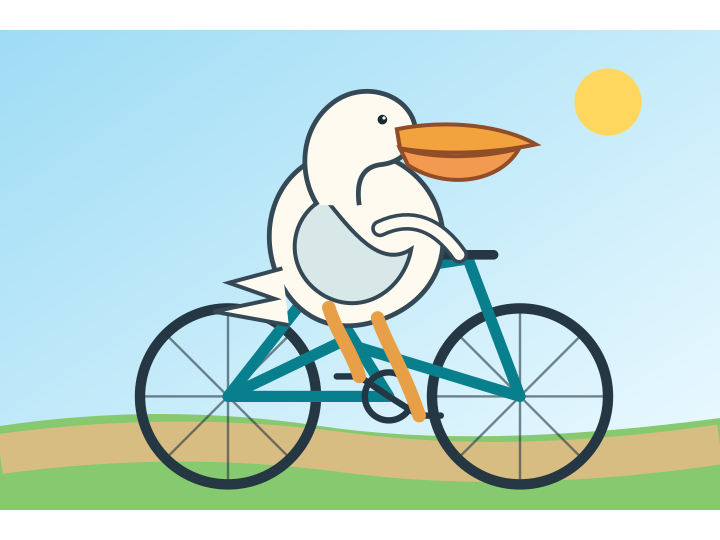
gpt-5.6-sol
low · 运行 2
原始 SVG
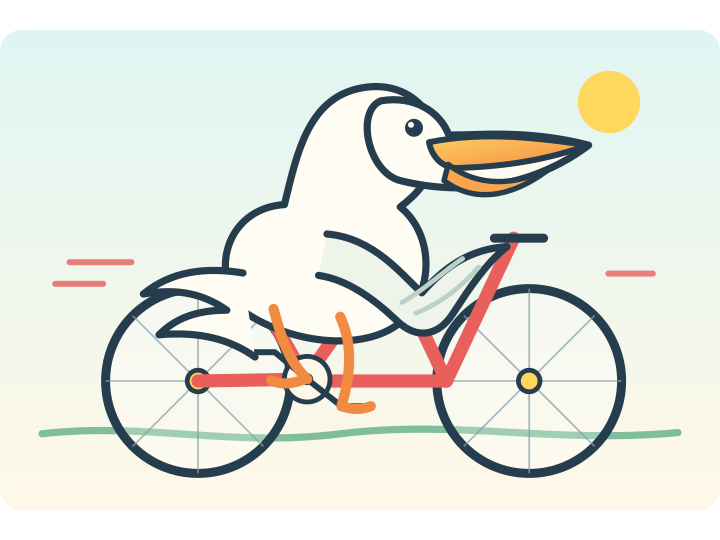
gpt-5.6-sol
high · 运行 2
原始 SVG
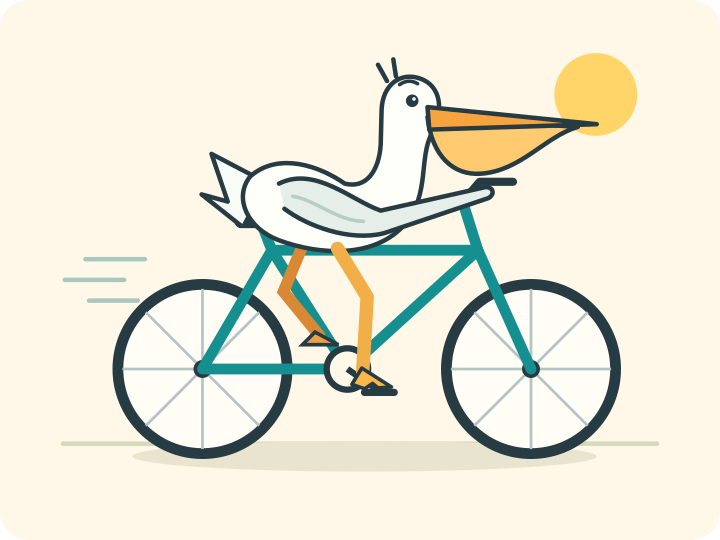
gpt-6-astra
low · 运行 2
原始 SVG
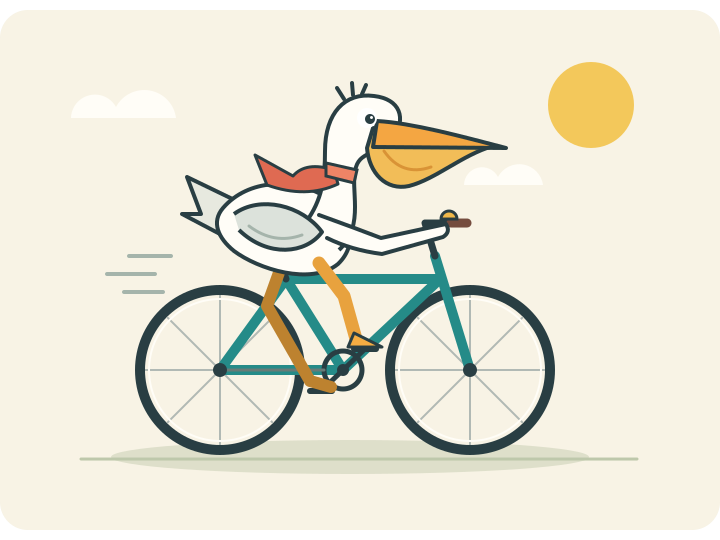
gpt-6-astra
high · 运行 2
原始 SVG
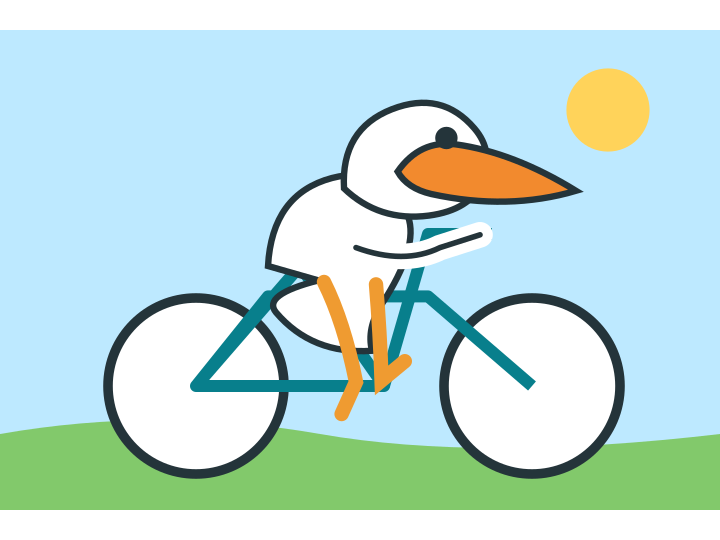
gpt-5.6-sol
low · 运行 3
原始 SVG
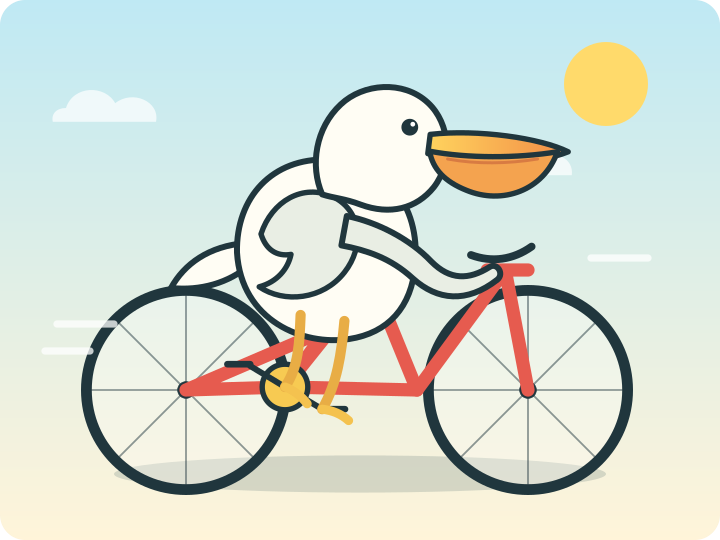
gpt-5.6-sol
high · 运行 3
原始 SVG
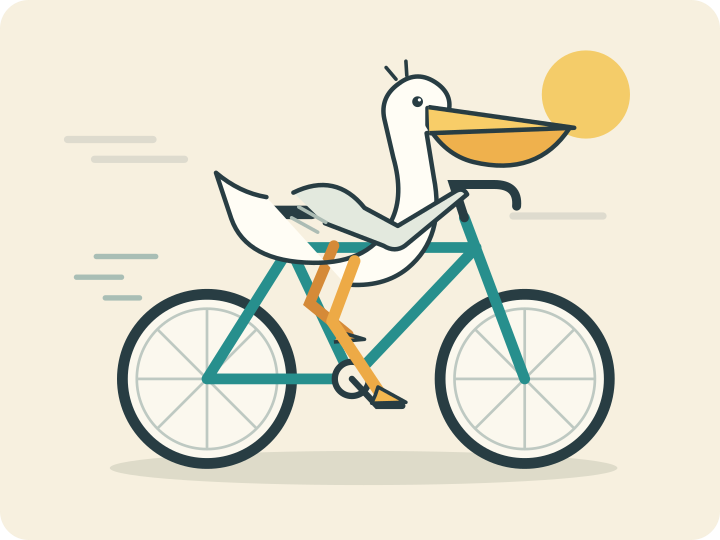
gpt-6-astra
low · 运行 3
原始 SVG
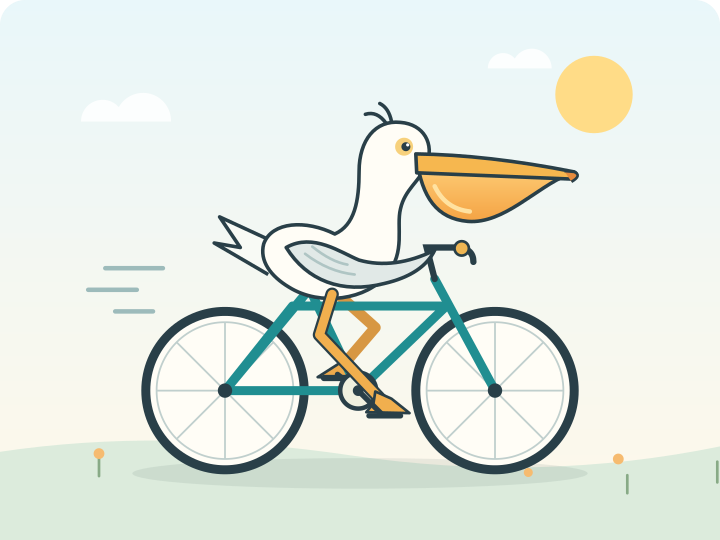
gpt-6-astra
high · 运行 3
原始 SVG
怎样让比较更公平
- 明确选择模型和推理强度,记录产品或 CLI 版本与日期。
- 用全新对话、相同提示词、工具权限和指令开始。无法保持一致的条件也要记录。
- 每个设置重复运行几次,保留失败和普通结果,不能只选最好的一张。
- 保存原始回复。从代码块提取 SVG 可以记录为格式处理,但不要悄悄修补模型画错的部分。
- 把耗时与画面质量分开。网络等待和工具调用都可能增加总耗时。
- 如果进行了追问修改,要标注为多轮尝试,并保留后续提示词。
一份有用的记录至少包括:请求的模型、推理强度、完整提示词、时间、运行编号、原始 SVG,以及是否编辑或重试。客户端中选择的模型名称不能独立证实后端具体快照。
它不能证明什么
一张图无法证明 Codex 降智、服务商更换了模型,或某个模型最擅长软件工程。这个提示词已经公开传播很久,模型对它的熟悉程度也可能影响比较的意义。
Willison 明确提醒过,鹈鹕画得更好不等于模型整体更强。他在 2026 年 9 月的 Astra 比较中也把推理设置作为实验条件。记录设置并保留多次尝试,比发布一个没有条件说明的排名更有用。
如果要检查实际工作中的可靠性,应选一个验收标准明确、能够重复检查的小任务。Codex 变慢或质量下降?排查指南给出了具体步骤。
分享时带上运行条件
可以提交画作时填写实际使用的模型与提示词,在分享说明中补充推理强度和生成日期。社区标签由投稿者提供;公开展示不代表本站验证了模型身份,也不代表已经证实质量回退。